


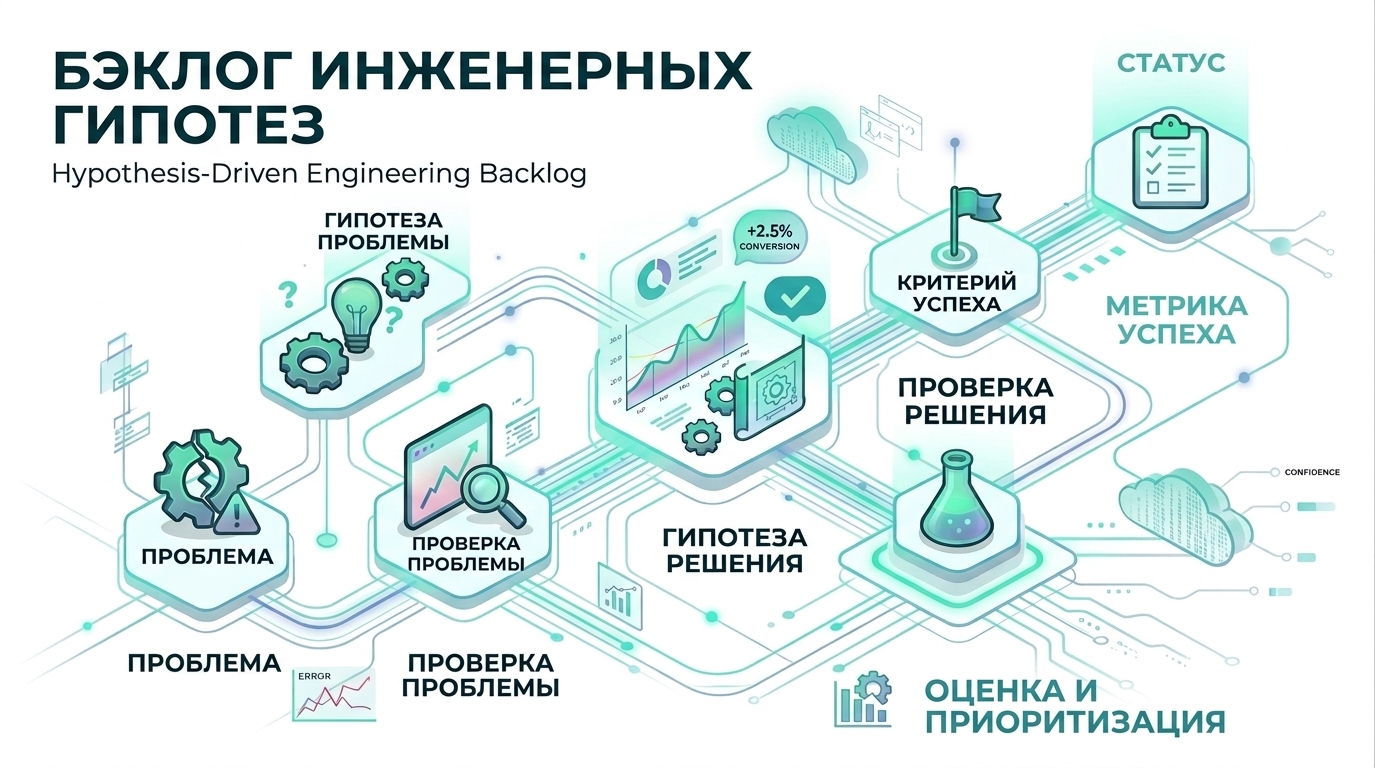
Hypothesis-Driven Engineering Backlog — подход для работы с техническими проблемами и улучшениями через формулирование и проверку гипотез.
Основной принцип:
- Описать проблему — зафиксировать, что именно работает не так.
- Сформулировать гипотезу проблемы — предположить, почему возникает проблема.
- Проверить проблему и гипотезу — подтвердить метриками, что проблема существует и что предполагаемая причина действительно может на неё влиять.
- Сформулировать гипотезу решения — предложить изменение, которое потенциально решит проблему.
- Определить способ проверки решения — определить, какие метрики и эксперименты покажут, что предложенное решение рабочее.
- Определить метрику успеха — зафиксировать измеримый результат, по которому команда поймёт, что проблема решена.
- Оценить потенциал и уверенность — определить максимальный потенциальный эффект решения и уровень уверенности команды в том, что этот эффект будет достигнут.
Подход помогает перейти от «давайте что-нибудь оптимизируем» к работе с конкретными предположениями, которые можно подтвердить или опровергнуть данными.
Когда полезно
Когда есть сложная техническая проблема и много идей по улучшению системы, но непонятно:
- что является причиной проблемы;
- какое решение даст наибольший эффект;
- как проверить, что решение действительно помогло;
- на какие технические улучшения стоит потратить ресурсы в первую очередь.
Кому полезно
- Tech Lead
- Staff Engineer / Technical Leader
- Engineering Manager
- Product Manager
- ML / SRE / Platform-командам
- Командам, работающим со сложными или высоконагруженными системами
Какую проблему решает
Помогает превратить технические наблюдения и идеи в проверяемые гипотезы, приоритизировать их по потенциальному эффекту и принимать решения на основе данных.
Вместо:
«Не хватает ресурсов → нам нужно добавить ресурсов»
получаем:
Проблема: текущих ресурсов может не хватить при прогнозируемом росте нагрузки
Гипотеза: рост нагрузки приведёт к выходу за целевой latency
Проверка гипотезы: по метриками rps видим, что при достижении порога, получаем деградацию
Решение: увеличить количество ресурсов
Проверка решения: сравнить утилизацию ресурсов и latency до/после
Критерий успеха: p98 latency остаётся в целевом диапазоне при прогнозируемой нагрузк
Когда подход избыточен
Подход относительно сложный, поэтому его не стоит применять к задачам с понятной проблемой и очевидной областью решений.
Если команда уже понимает:
- что именно не работает;
- почему это происходит;
- какое изменение нужно внести;
- как проверить результат,
дополнительная формализация гипотез проблем и решений добавит процессную сложность.
Для задач с понятным алгоритмом решения используйте более простые инструменты: технический RFC для описания технического решения и паспорт фичи для формализации требований к продуктовой функциональности.
Backlog гипотез
Пример
| Проблема | Гипотеза проблемы | Как проверяем | Гипотеза решения | Как проверяем | Метрика успеха | Потенциал (max) | Confidence | Статус |
|---|---|---|---|---|---|---|---|---|
| Наблюдаемая проблема или возможность для улучшения | Предположение о причине проблемы или механизме, который приводит к наблюдаемому эффекту | Способ проверить наличие проблемы и гипотезу: метрики, логи, трейсы, данные, интервью и т. д. | Предположение о том, какое изменение позволит решить проблему или получить желаемый эффект | Способ проверить эффективность решения: эксперимент, A/B-тест, сравнение до/после, нагрузочное тестирование и т. д. | Измеримый критерий, по которому определяем, достигнут ли ожидаемый эффект | Максимальный потенциальный эффект от реализации гипотезы. Используется для приоритизации | Уверенность команды в гипотезе и оценке потенциального эффекта | Текущий статус гипотезы: New, In progress, Confirmed, Rejected, Implemented, Monitoring , Done |
| Повторное выполнение операций создаёт дополнительную нагрузку на систему | Операция может продолжать выполняться после истечения времени ожидания, поэтому повторная попытка приводит к дублированию работы | Анализируем связь между timeout, retry и повторным выполнением операций | Увеличение допустимого времени ожидания позволит завершать больше длительных операций без повторного выполнения | Сравниваем количество retry и повторных операций до и после изменения; контролируем latency и нагрузку | Снижение количества повторных операций без ухудшения latency и качества сервиса | Снижение дополнительной нагрузки | High | New |
Принцип приоритезации
Не каждая техническая проблема должна становиться задачей разработки.
Сначала проверяем:
- Проблема существует?
- Насколько велик её эффект?
- Есть ли подтверждённая гипотеза причины?
- Есть ли решение с потенциально значимым эффектом?
- Можно ли измерить результат?
В разработку в первую очередь попадают гипотезы с высоким Потенциалом и достаточной Уверенностью, которые можно относительно быстро проверить.
Таким образом, список становится бэклогом технических гипотез и экспериментов, из которого команда выбирает наиболее перспективные направления для работы.